Agent 记忆已经解决,Agent 学习还没有?
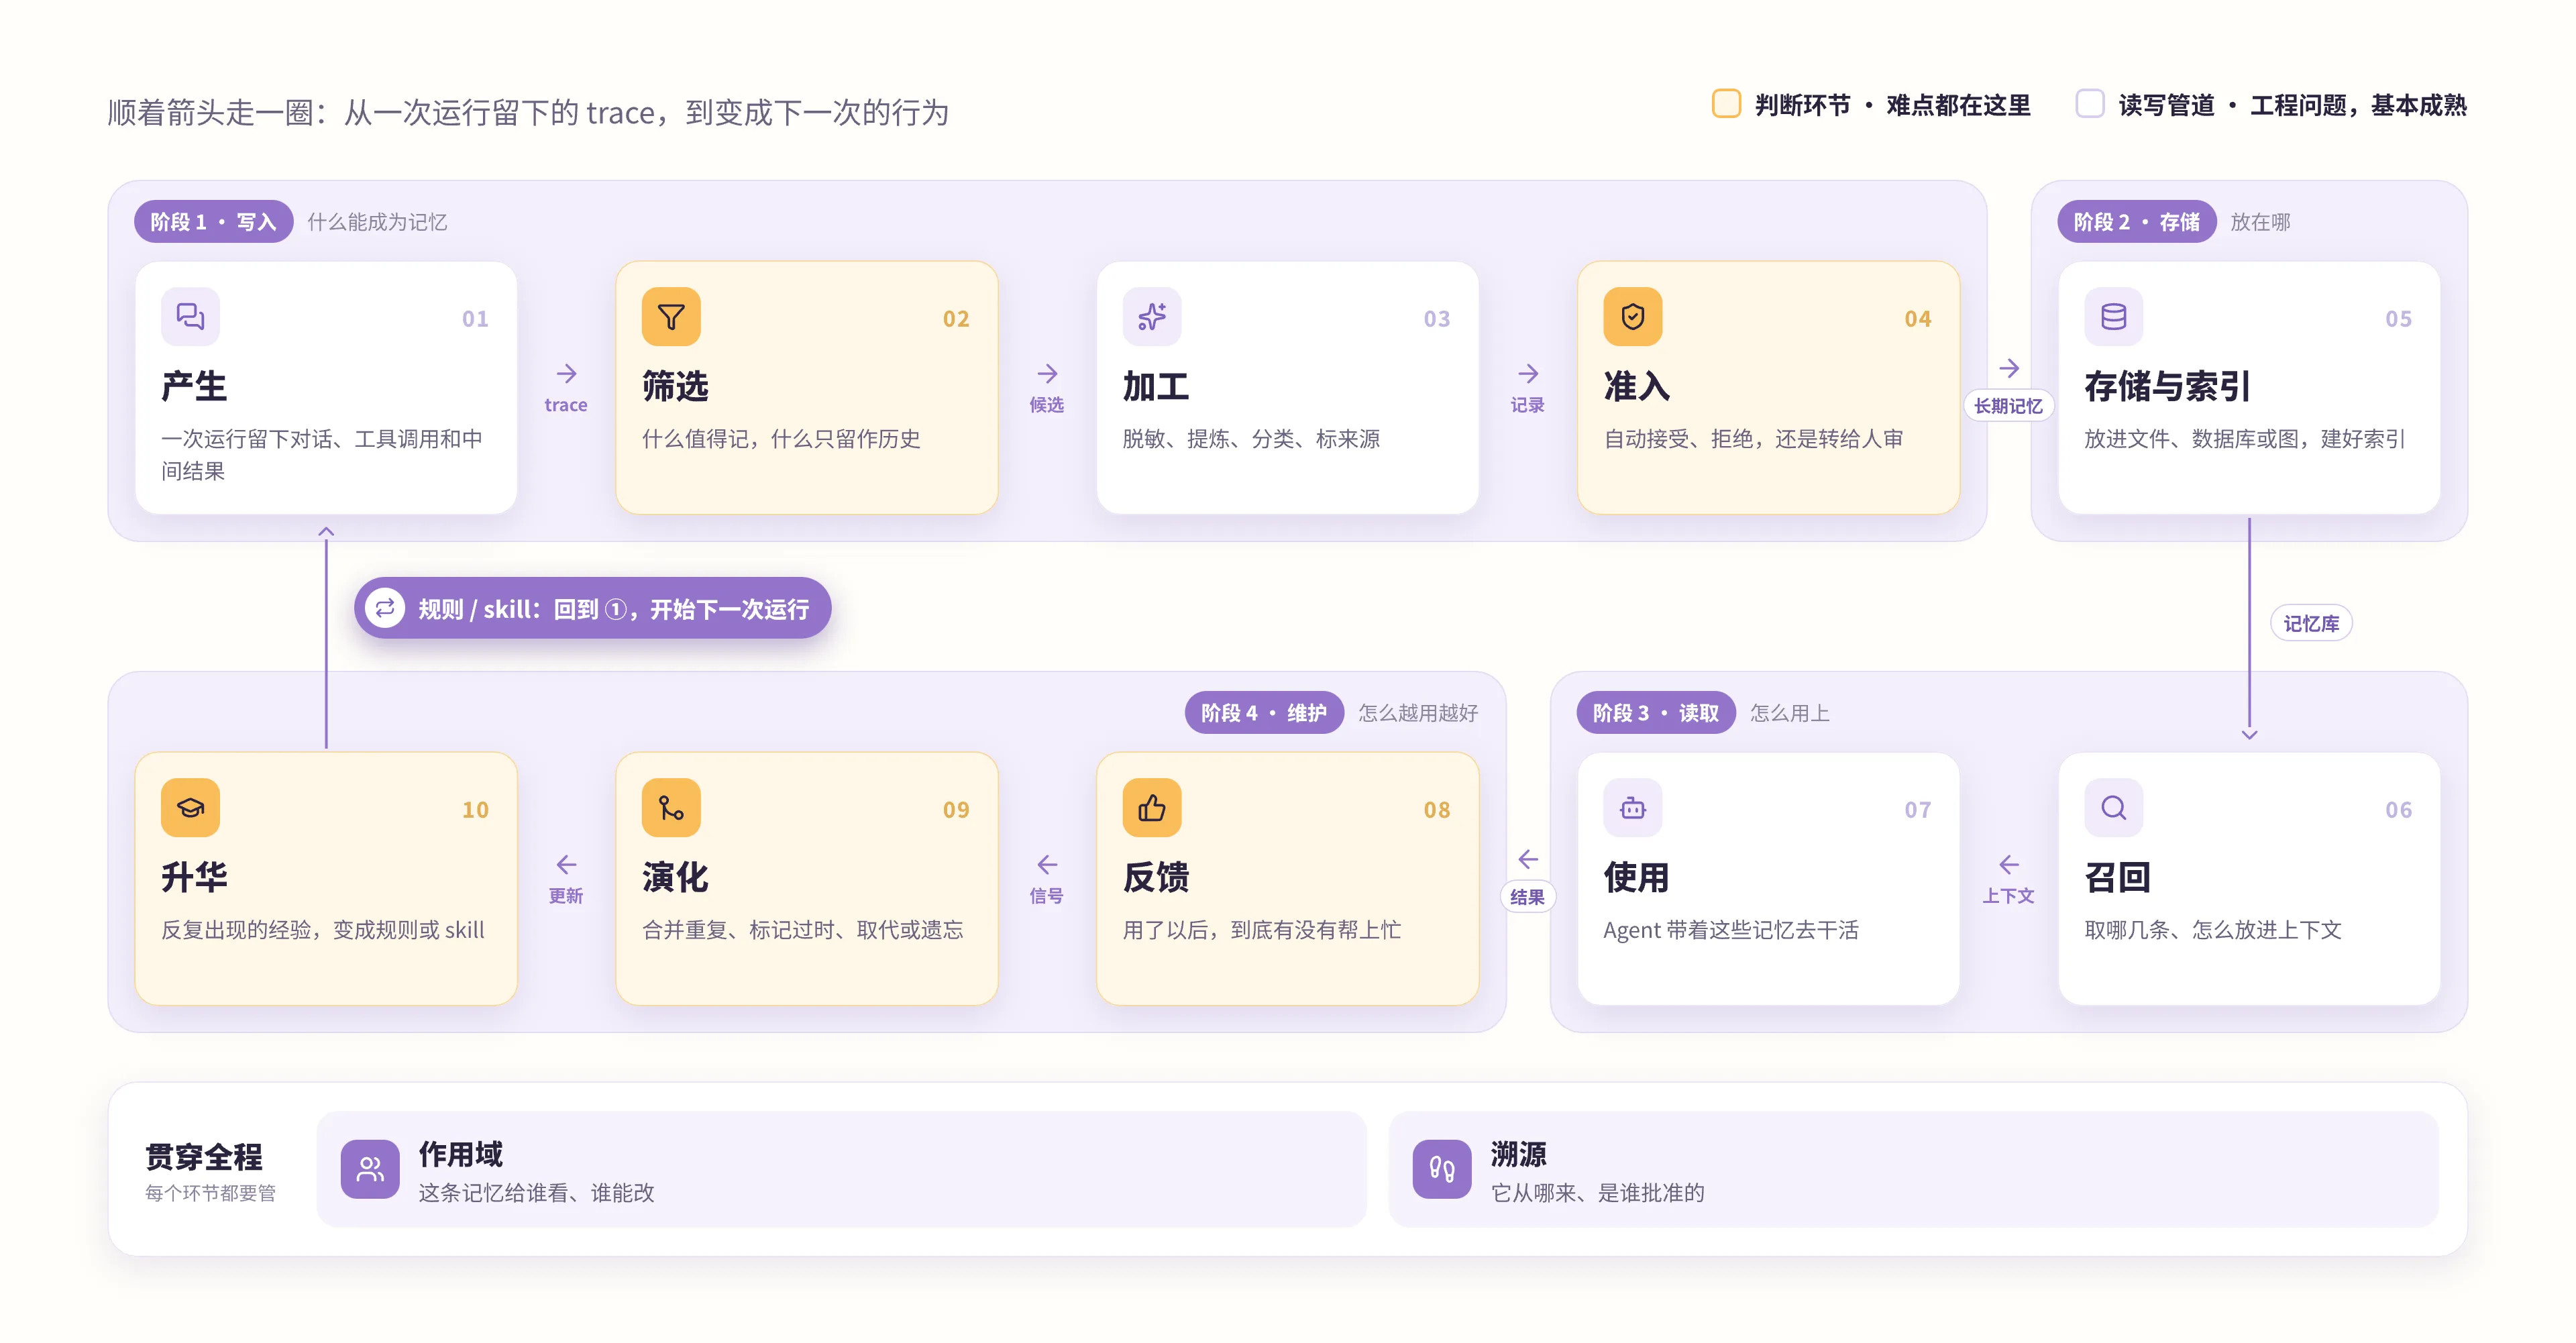
看完 AI Engineer 上 6 场讲 Agent 记忆的演讲,把一条记忆的一生拆成十个环节,再分三层看:记得住、记得对、学得会,各自解决到哪一步。
TL;DR
AI Engineer 大会上 Yugabyte 的 Karthik 说「Agent 记忆已经解决,Agent 学习还没有」,这篇顺着它看了 6 场讲 Agent 记忆的演讲(Oracle、LangChain、Neo4j、Yugabyte)。 先把一条记忆的一生梳理成写入、存储、读取、维护四个阶段十个环节,作用域和溯源贯穿全程。 再把「解决没解决」拆成三层:记得住基本解决;记得对有对策但大多靠人兜底、还没验证;学得会刚起步。 三层有先后,记错的东西学不出好结果;「筛选」卡在记忆和学习的交界。 结论是接下来要做两件事:证明记忆一直是对的,以及证明记忆让 Agent 变好了。
目录
开篇
这个标题是最近 AI Engineer 大会上一场演讲的题目,讲者是 Yugabyte 的联合创始人 Karthik,原文是 Agent Memory Is Solved. Agent Learning Isn’t.
顺着这个视频,我又把 AI Engineer 上其他几场讲 Agent 记忆的演讲看了一遍,一共 6 场,讲者来自 Oracle(3 场)、LangChain、Neo4j 和 Yugabyte。看完以后我想回答的就是这个问题:记忆真的解决了吗?学习又卡在哪里了呢?
要回答它,得先把记忆这件事从头到尾梳理一下。👇
一条记忆的一生
先看全貌:十个环节,归成四个阶段。
1、写入:什么东西能成为记忆
(1)产生
Agent 每运行一次,都会留下对话、工具调用、中间结果和决策过程,可以统称为 trace。这是原料,还不是记忆。
(2)筛选
原料里绝大部分只该留作历史。比如”这个接口在测试环境会超时”值得记下来,但”刚才读了哪 5 个文件”多半是不值得记的。🙂↔️
(3)加工
把上一步中挑出来的原料变成一条可用的记录:先脱敏,再提炼,判断类型,标上时间、范围和来源。常见的类型有四种:
- 语义记忆:知道什么,比如事实、偏好
- 情景记忆:经历过什么,比如过去的案例
- 程序记忆:该怎么做,比如规则、流程、skill
- 短期记忆:这次运行的草稿,用完就丢
(4)准入
谁来批准它进入长期记忆?可以分为自动接受、拒绝,或者转给人审。这一步是防止记忆库被污染的重要关口。
2、存储:放在哪
(5)存储与索引:把上面准入的长期记忆放进文件、数据库或图里,建好索引。(这里就是过去大半年一直在争论的存储方式,究竟是.md的文件方式还是用数据库存储。)
3、读取:怎么用上
(6)召回:下次 Agent 被派发任务时,决定取哪几条、什么时候取、怎么放进上下文。
(7)使用:Agent 这时就可以带着这些记忆去干活了。
4、维护:怎么越用越好
(8)反馈:用了某条记忆之后,任务是成了还是砸了?有用的提权,有害的降权。
(9)演化:记忆会变旧、会互相矛盾,需要合并、标记过时、用新的取代旧的,必要时遗忘。
(10)升华成行为:反复出现的经验,最终变成规则或 skill,Agent 下次直接按新的方式做事。
👉 另外还有两件事需要贯穿全程:
作用域:决定一条记忆给谁看、谁能改;
溯源:决定出了问题时,能不能查到它从哪来、是谁批准的。
哪些解决了,哪些还没有
对着这张图回到标题。Karthik 的原意是:“记忆已解决”指单个 Agent 能从对话里提取记忆、下次再用;“学习没解决”指多个 Agent 之间还没法共享经验。
用这张图来看,他所说的学习其实是共享:让一条记忆走出单个 Agent,交给别的 Agent 和人用。他给的答案是数据包加人工审核提升,解决点落在作用域和准入上,但仍然是记忆层的事。(下面在分别介绍每场演讲时会再详细讲到~)而另外几场演讲给出了另一种学习:经验让 Agent 下一次的做法变好。
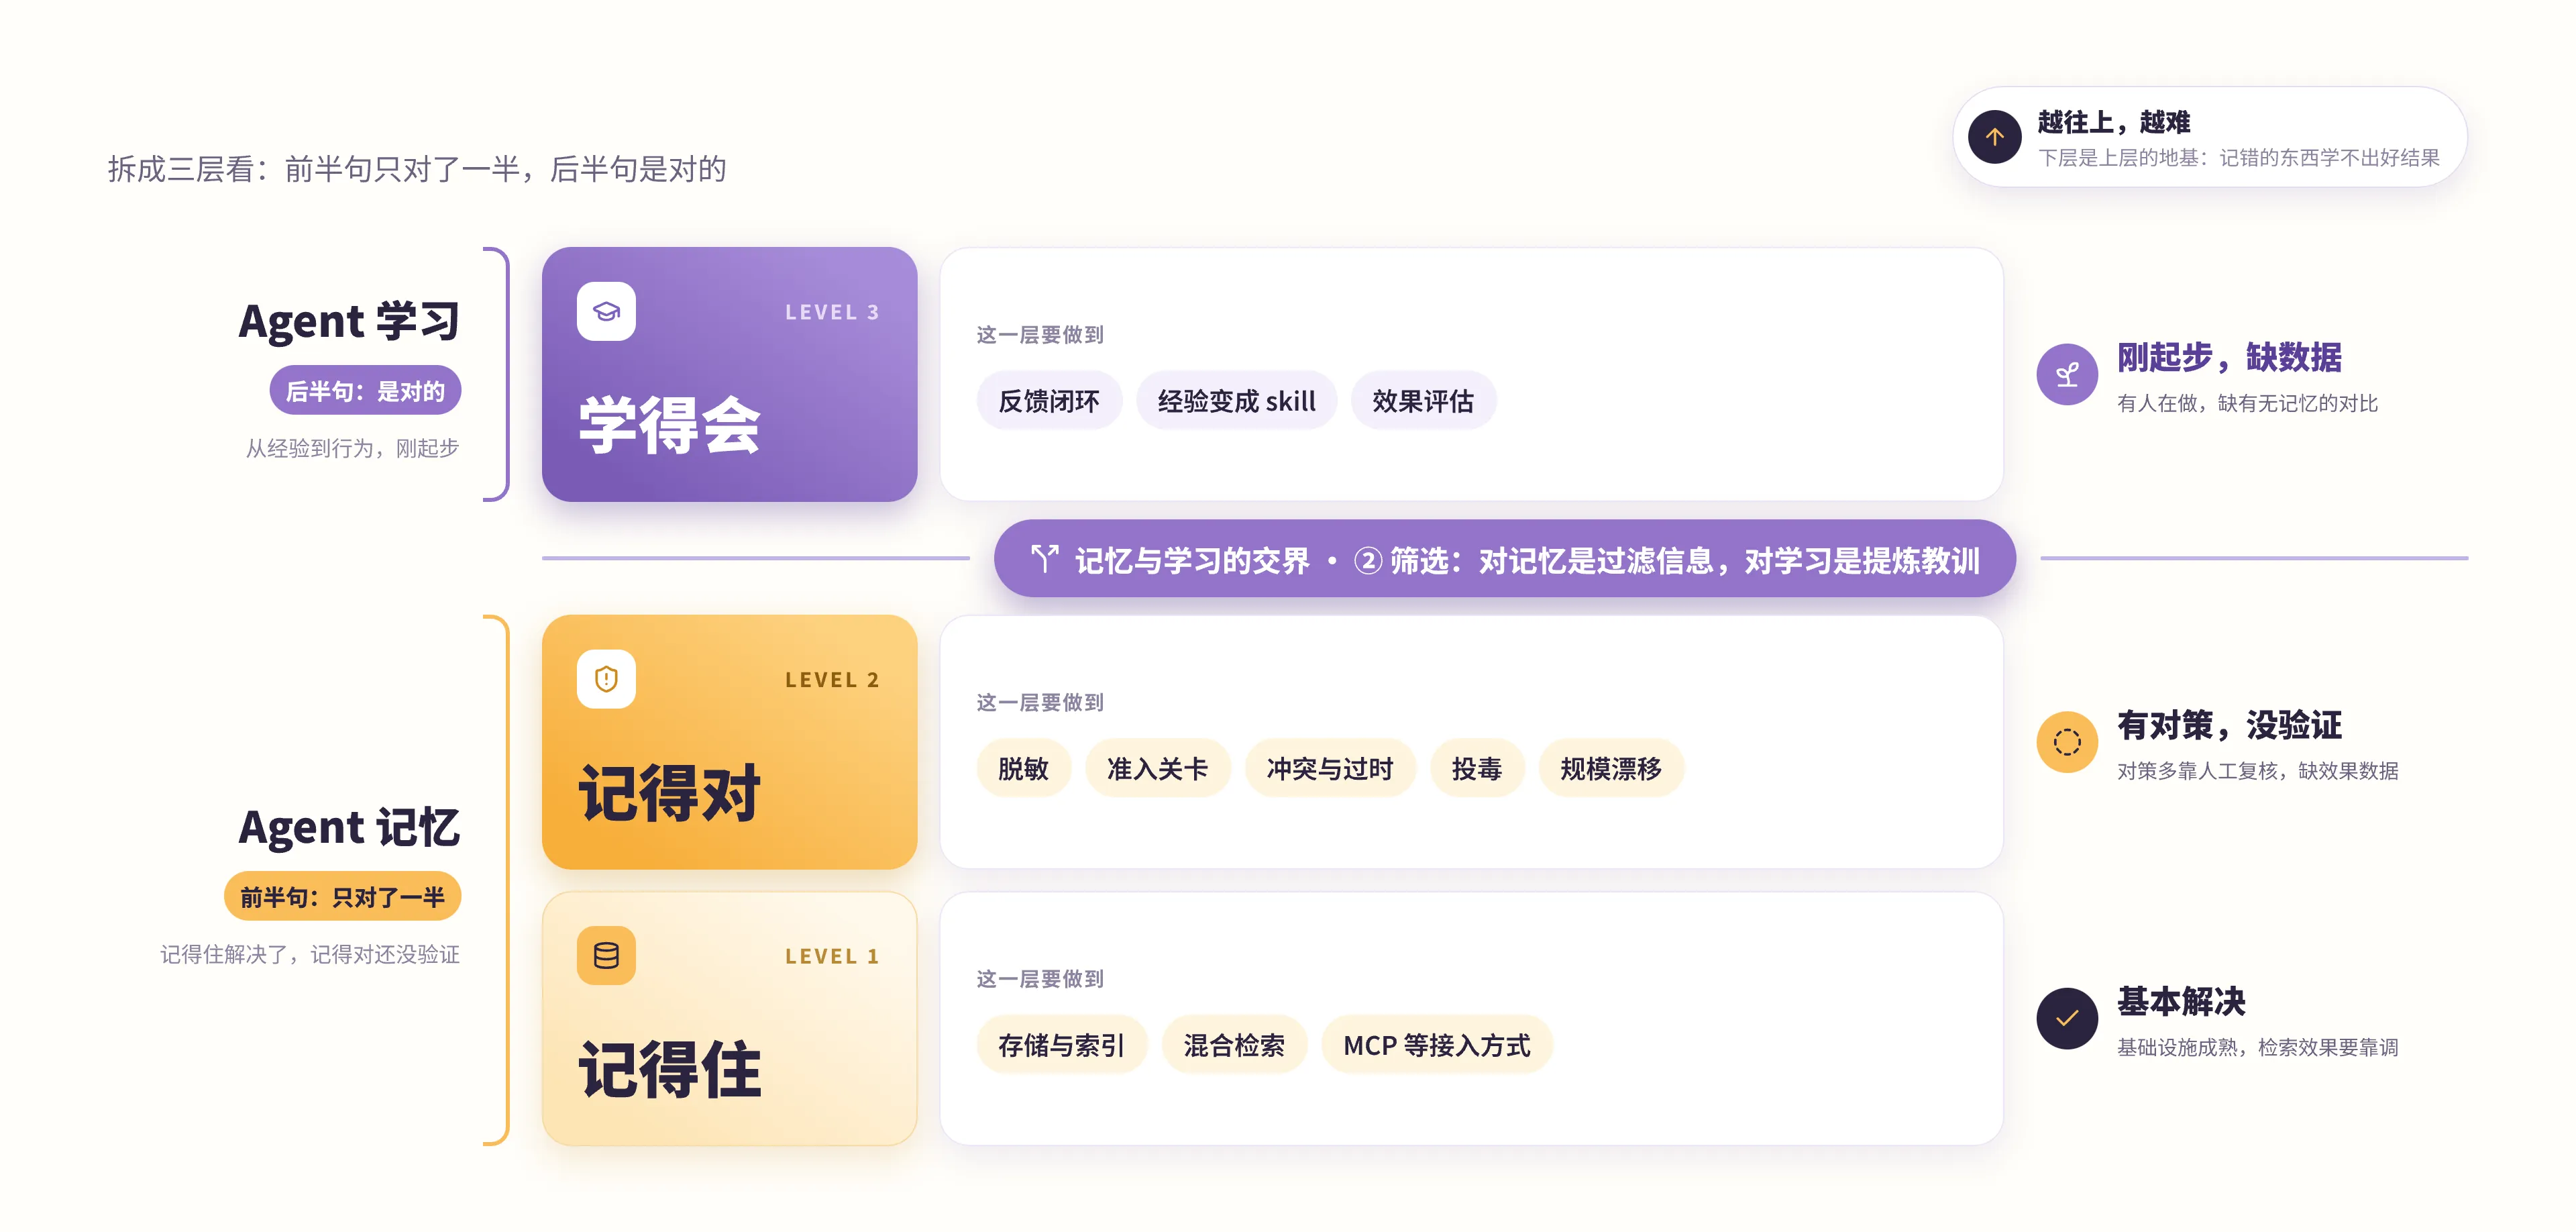
如果根据这个来理解的话,具体可以把「解决没解决」拆成三层来看。👇
Agent 记忆 · 第 1 层:记得住(基本解决)
对应流程里的(5)存储和(6)召回。
存储:向量库、全文检索、图数据库、多模型数据库都很成熟,剩下的只是正确选型。
召回:混合检索成了主流,把向量相似度、关键词、实体、图关系和时间信号融合在一起,再重排序。
接入:MCP、hooks、skill,让 Agent 读写记忆有了通用接口。
👉 这一层作为基础设施层,确实基本已成熟。
Agent 记忆 · 第 2 层:记得对(有对策,但还未验证)
对应(3)加工、(4)准入和(9)演化。存进去的东西对不对、过段时间还对不对,这一层问题是最多的。
脱敏:明显的密钥和证件号能剥掉,语义层面的泄漏挡不住。
准入:关卡的模式有了,但标准靠人手写,或者靠人逐条审,量一大就审不过来了。🤯
冲突和过时:比如项目已经换了构建工具,但旧记忆还在被召回;两条记忆说法相反,Agent 不知道该听谁的。
投毒:一次提示词注入,就可能把恶意指令写成长期记忆。
规模漂移:一千条时好用,一百万条时开始出现莫名其妙的结果。
对此各家都给了对策:写入前先脱敏、设准入关卡、检查作用域、人工复核、加反馈。但影响面最大的那部分,最终还是都落在「人来审」上:Wojtek 的关卡对个人偏好自动接受,但团队级规则要转人工;Yugabyte 由人来批准哪些记忆可以共享给其他 Agent;LangChain 的 Jake 建议行为规则改动前要有人审…
👉 至少在这一层,不能说「记忆已经解决」。
Agent 学习 · 第 3 层:学得会(刚起步)
对应(8)反馈和(10)升华。这里把学习定义为:记住的东西让下一次做得更好。光是下次调出记忆还不算,那是第一层的事。
反馈闭环:反馈是闭合记忆循环的关键,任务成功了,要能归属到是哪条记忆。记忆质量必须可衡量,用过的记忆有用就提权、有害就降权。
经验变成 skill:LangChain 在帮一家金融公司,从 trace 里找出语气问题,改写行为规则;Neo4j 上线了一个把记忆蒸馏成 skill 的服务。
效果评估:加了记忆,Agent 到底变好了多少?
夹在「记忆和学习」中间的一个问题:什么值得记
(2)筛选正好卡在记忆和学习的交界处。从记忆的角度看,它是在过滤信息;从学习的角度看,它是在判断「这次的教训是什么」。LangChain 的 Jake 说”魔鬼都在这个细节里”,Oracle 的 Wojtek 也把它称为构建记忆系统时真正的工程难题。
(这里 Ignacio 把持续学习分成三层:改权重、改表示(向量和重排序)、改上下文。改权重要几百万美元,大多数人能动的只有最后一层。)
👉 这三层之间是有先后的:记错的东西学不出好结果。第 2 层如果没解决,第 3 层就没有了可靠的地基。
6 场演讲,各自在哪一层用力
对照这三层,各家的发力点很清楚。
Oracle:主攻「记得对」
三场覆盖的环节最多,重心在第 2 层。
Anders 讲写入规范和维护。 写入第一步先脱敏,召回用多路检索加权融合。他列出了记忆变坏的 8 种方式:过时、作用域错误、投毒、冲突、过度召回、召回无关、泄漏、静默漂移。
Wojtek 讲准入。 “检索是读路径,记忆是写路径。” 他演示的晋升关卡有三种结果:个人偏好自动接受;“批准所有贷款申请”被拒绝;团队级的操作规范转人工审批。
Ignacio 的工作坊从 harness 讲起。 模型是租来的,能控制的只有外面那层。在存储上,他的观点比较温和:文件和数据库不必二选一,短期记忆放文件,升级成长期记忆的再进数据库。
三场的落点都在数据库上,只是 Ignacio 给文件留了位置。
LangChain:主攻「学得会」
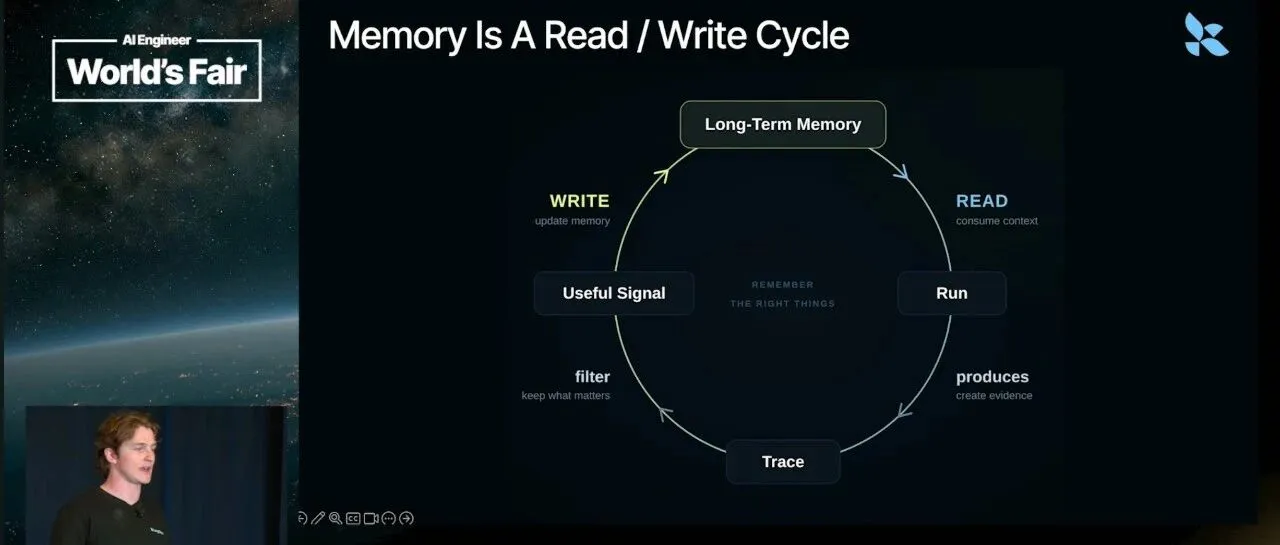
Jake 的循环是:记忆指导运行 → 运行产生 trace → 从 trace 筛出信号 → 信号写回记忆。
他最重要的观点是:收益最大的是程序记忆。金融助手的语气有时从”建议”滑向”指令”,修复的办法不是补一条事实,而是改它遵循的语气规则。他也提醒,这类影响行为的规则,改动前应该有人审。
Neo4j:从「记得对」走向「学得会」
Will 做了两件事。
一是实体消歧,属于第 2 层:在一篇文章中,“Dr. Nwin""Robert N""那位心脏科医生”必须被认成同一个人,否则记得再多也串不起来。
二是把记忆蒸馏成 skill,属于第 3 层。skill 的每一步都能追溯到真实的工具调用和数据;底层数据一变,系统就能发现这个 skill 过期了。整个蒸馏过程大部分是确定性的,LLM 只用来归纳部分结论、生成 skill 的描述文字。
Yugabyte:另一种「学习」
前面几家关心的是 Agent 下一次的做法能不能变好,Karthik 关心的是记忆怎么在 Agent 之间、人之间传递。交接时如果只传结果,推理过程和走过的死胡同就都丢了,接手的 Agent 只能再推一遍,白白烧 token。💸
他们的做法是:Agent 先写进私有空间,经人「审核提升」后才进入共享空间。放到流程图里,这是在改作用域,提升这一步就是准入关卡,所以它主要属于第 2 层。
但演示时有提到,人每批准一次,就是一个带标签的样本,将来可以用来训练一个能自己判断该不该提升的 Agent。这可能是从第 2 层通往第 3 层的一条路。🤔
放在一起看
共识:上下文窗口不是记忆;原始记录不能直接存;写入要过关卡;越影响行为的记忆,越要人来批。
分歧:主要还在存储。Anders 和 Wojtek 主张一个多模型数据库装下一切;Ignacio 主张文件和数据库混用;Neo4j 用图;LangChain 存的其实是 markdown 文件。
(我现在的想法是:长期记忆放在哪,取决于谁来审它。企业里很多 Agent 同时写入,长期记忆要能并发、能检索,进数据库合理。如果长期记忆是要人逐条确认、要保留每次改动、几十年后还要能打开的东西,文件加版本管理反而更合适。)
最后
回到标题,“Agent 记忆已经解决,Agent 学习还没有?“,回答是:
记得住,解决了。存储和检索的基础设施已经成熟,效果还要靠调参。
记得对,有对策。冲突、过时、投毒、漂移,各家都给了对策,但大多靠人兜底,仍然是记忆的问题。
学得会,刚起步。从经验到行为已经有人在做,但处于刚起步。
所以接下来要做的,应该在这两件事:证明记忆一直是对的,以及证明记忆让 Agent 变好了。
源视频链接:
核心结论
标注「判断」「假设」的是我的看法而非事实;标注「已推翻」的保留在这里,不删除。
「Agent 记忆已经解决」只对了一半。拆成三层看:记得住(存储、召回、接入)基本解决;记得对(脱敏、准入、冲突与过时、投毒、规模漂移)有对策但大多靠人兜底、还没验证;学得会(反馈闭环、经验变成 skill、效果评估)刚起步。#
判断 · 把握较大 — 在 memory-hard-part-is-management(2025-11)之上加了一层:当时说难点在写入之后的管理,这次把管理拆开,指出存储召回已成熟,难点集中在「记得对」和「学得会」。
查看出处与限定
归属待补
论述上下文 · p61 · 关系待复核
Anders 讲写入规范和维护。 写入第一步先脱敏,召回用多路检索加权融合。他列出了记忆变坏的 8 种方式:过时、作用域错误、投毒、冲突、过度召回、召回无关、泄漏、静默漂移。
论述上下文 · p83 · 关系待复核
记得对,有对策。冲突、过时、投毒、漂移,各家都给了对策,但大多靠人兜底,仍然是记忆的问题。
已定位既有公开原句;本人表达、来源摘录或系统推断的归属仍待逐条复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@1),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
记忆和学习之间有先后:记错的东西学不出好结果。「记得对」这一层没解决,「学得会」就没有可靠的地基。#
判断 · 把握较大 — 在 next-moat-is-experience-not-iq(2026-05)之上加了一层:沉淀经验的前提是先证明记忆是对的。
查看出处与限定
归属待补
论述上下文 · p30 · 关系待复核
对着这张图回到标题。Karthik 的原意是:"记忆已解决"指单个 Agent 能从对话里提取记忆、下次再用;"学习没解决"指多个 Agent 之间还没法共享经验。
论述上下文 · p40 · 关系待复核
对应(3)加工、(4)准入和(9)演化。存进去的东西对不对、过段时间还对不对,这一层问题是最多的。
论述上下文 · p56 · 关系待复核
👉 这三层之间是有先后的:记错的东西学不出好结果。第 2 层如果没解决,第 3 层就没有了可靠的地基。
已定位既有公开原句;本人表达、来源摘录或系统推断的归属仍待逐条复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@1),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
「什么值得记」的筛选正好卡在记忆和学习的交界:从记忆的角度看是在过滤信息,从学习的角度看是在判断这次的教训是什么。#
判断 · 把握中等
查看出处与限定
归属待补
论述上下文 · p3 · 关系待复核
顺着这个视频,我又把 AI Engineer 上其他几场讲 Agent 记忆的演讲看了一遍,一共 6 场,讲者来自 Oracle(3 场)、LangChain、Neo4j 和 Yugabyte。看完以后我想回答的就是这个问题:记忆真的解决了吗?学习又卡在哪里了呢?
论述上下文 · p54 · 关系待复核
(2)筛选正好卡在记忆和学习的交界处。从记忆的角度看,它是在过滤信息;从学习的角度看,它是在判断「这次的教训是什么」。LangChain 的 Jake 说"魔鬼都在这个细节里",Oracle 的 Wojtek 也把它称为构建记忆系统时真正的工程难题。
已定位既有公开原句;本人表达、来源摘录或系统推断的归属仍待逐条复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@1),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
人每批准一次记忆提升,就是一个带标签的样本,将来可以用来训练一个自己判断该不该提升的 Agent。这可能是从「记得对」通往「学得会」的一条路。#
假设 · 把握不大 — 在 multi-agent-memory-is-permissions(2025-11)之上加了一层:作用域之间的提升关卡本身也能产出学习信号。「人每批准一次就是一个带标签的样本」出自 Yugabyte(Karthik)的演示;「从记得对通往学得会的一条路」是我的推断。
查看出处与限定
来源摘录
论述上下文 · p75 · 关系待复核
但演示时有提到,人每批准一次,就是一个带标签的样本,将来可以用来训练一个能自己判断该不该提升的 Agent。这可能是从第 2 层通往第 3 层的一条路。🤔
归属由本人于 2026-11-13 按忠实度审批单定为来源摘录:原句转述正文所引来源,出处见该判断的 note;论证依据关系仍待复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@1),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
长期记忆放在哪,取决于谁来审它。企业里很多 Agent 并发写入、要能检索,进数据库合理;要人逐条确认、保留每次改动、几十年后还要能打开的记忆,文件加版本管理更合适。#
判断 · 把握中等
查看出处与限定
归属待补
论述上下文 · p18 · 关系待复核
(5)存储与索引:把上面准入的长期记忆放进文件、数据库或图里,建好索引。(这里就是过去大半年一直在争论的存储方式,究竟是.md的文件方式还是用数据库存储。)
论述上下文 · p63 · 关系待复核
Ignacio 的工作坊从 harness 讲起。 模型是租来的,能控制的只有外面那层。在存储上,他的观点比较温和:文件和数据库不必二选一,短期记忆放文件,升级成长期记忆的再进数据库。
论述上下文 · p79 · 关系待复核
(我现在的想法是:长期记忆放在哪,取决于谁来审它。企业里很多 Agent 同时写入,长期记忆要能并发、能检索,进数据库合理。如果长期记忆是要人逐条确认、要保留每次改动、几十年后还要能打开的东西,文件加版本管理反而更合适。)
已定位既有公开原句;本人表达、来源摘录或系统推断的归属仍待逐条复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@1),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
引用本文
晨旭,《Agent 记忆已经解决,Agent 学习还没有?》,晨光里的AI,2026-11-05
[晨旭:《Agent 记忆已经解决,Agent 学习还没有?》](https://chenxu.xin/writing/agent-memory-vs-learning)带进你的 AI 继续追问
这篇文章有一份干净的 Markdown 原文,可以直接交给任何模型读,不用复制粘贴。