关于 SI 和 RSI:AI 跑了一万次实验,谁变聪明了?
分辨自我改进(SI)和递归自我改进(RSI)只需要问一个问题:被改进的是产物,还是提出改进方案的那个系统?用我自己网站上的问答实验,把一个闭环的三件东西摆出来看。
TL;DR
SI 与 RSI 的区别,看的是实验改进了目标产物,还是改进了负责提出下一轮方案的系统。要用这个判据,得先把闭环拆成生成器、执行器、验证器,找到生成器在哪。我用自己网站上的问答评测当实例:五轮改动全是 SI,验证器决定了循环往哪跑,也决定了跑多快。想让闭环离开人一直跑,难的不是让 Agent 多干活,而是让验证器不再是我。
目录
五个月前拆 Karpathy 的 autoresearch 时,我用的词是「自进化」。文章里特意补过一句:真正被进化的是 train.py 这套训练系统,不是外层 Agent 自己的大脑。
最近看了李飞飞教授与 Jeff Dean 在斯坦福 HAI 的对谈,两人花了不少时间解释自我改进(SI)和递归自我改进(RSI)。看完才意识到,我当时说的「自进化」其实是两件事,而我把它们放在同一个框架里理解了。
这篇文章就是把这条分界线理清楚:先用一个判据区分二者,再把循环分拆清楚,最后用我自己的一个小实验演示这个过程。👇
判据:改的是什么?
视频中 Jeff Dean 把科研和工程描述成一个循环:提出方案,跑实验,看结果,决定下一步。这个循环一直都有,只是之前研究员要亲自拆解、编程、等待和判断,现在 Agent 可以让其中一些环节连续运行、并行展开。
提出下一步方案 → 实现并运行 → 测量结果 → 保留或回退 → 再提出方案但是循环本身不能说明它是不是 RSI。关键点在于最后留下了什么,以及留下的东西有没有进入下一轮。
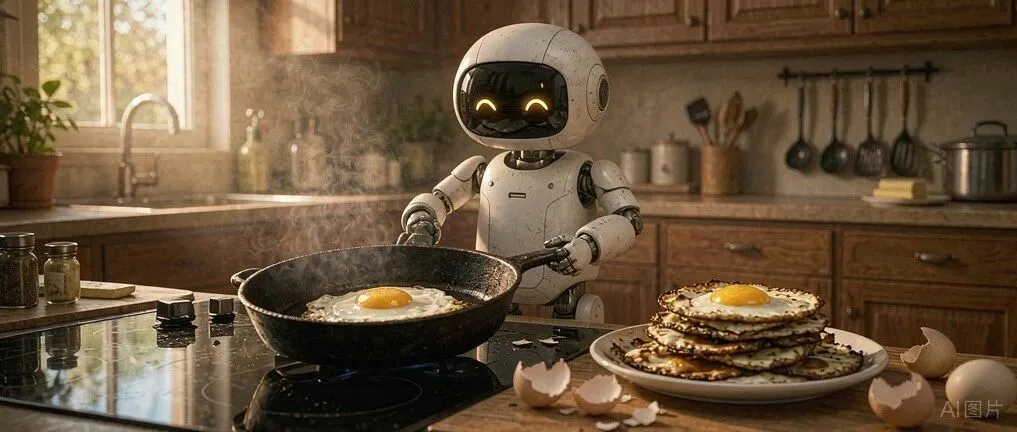
李飞飞教授打了一个很形象的比喻:学煎蛋,前几次糊了,第十次做出能吃的,这是 SI:你会煎蛋了,脑子没变。如果在学煎蛋的过程中改造了大脑的连接方式,学会了「怎么学」,以后学微积分、学编程都比以前更快了,这才是 RSI。
所以判据只有一条:被改的是产物,还是提出改进的那个系统。
可以先把它展开成三个问题,第一问确认改进发生在哪里,后两问是是否改进的证据:
- 这轮改变了什么?
- 改动进入下一轮了吗?
- 换一道同类新题还有效果吗?
判据只有一条,但要用它,还要能指出「提出改进的那个系统」是这个循环里的哪一部分。所以要先把循环拆开。👇
拆开循环:三件东西
任何一个自我改进闭环,拆开都是三件东西:
- 生成器:看当前状态和历史记录,提出下一个改动
- 执行器:把改动跑一遍
- 验证器:说这次是好是坏
三件里面,生成器和执行器决定循环跑不跑得动,验证器决定它往哪跑:
代码跑得快不快,测试过不过,证明过不过,这些问题可以给出一个几乎没有噪声的对错。有这样的验证器,闭环就能转起来,而且可以转得很快。
但产品设计好不好、是否理解原意,这些反馈慢、有噪声、没有明确的奖励函数。验证器一模糊,生成器就会朝让验证器满意的方向漂,而不是朝真的变好的方向。误差一轮轮累积,闭环就塌了。🥲
这也解释了为什么 coding agent 落地最快:它的验证器干净。
上面判据里说的「提出改进的那个系统」,就是生成器。SI 用生成器,RSI 改生成器。 带着这句话看下面的实验。👇
一个小实验
上一篇《当读者是 Agent,内容的最小单位不再是文章》里,我提出内容方应该把判断、来源和版本维护清楚,让陌生的 Agent 能准确使用。为了验证那个设想,我在自己的网站上搭了一套评测:固定的题目,全新上下文的读者 Agent,独立的裁判,最后由我本人看。
这套评测跑了五轮,每一轮都在改东西、测东西、决定留不留。它就是一个自我改进的闭环,前沿实验室的闭环离我很远,但手边的这个小实验我可以一步一步拆开看。👇
SI 的一轮是怎么跑的?
先补几个细节:每题有必须答到的要点和不能犯的错;读者 Agent 只能用公开工具;裁判逐句评断言,另有程序核对每条引用。
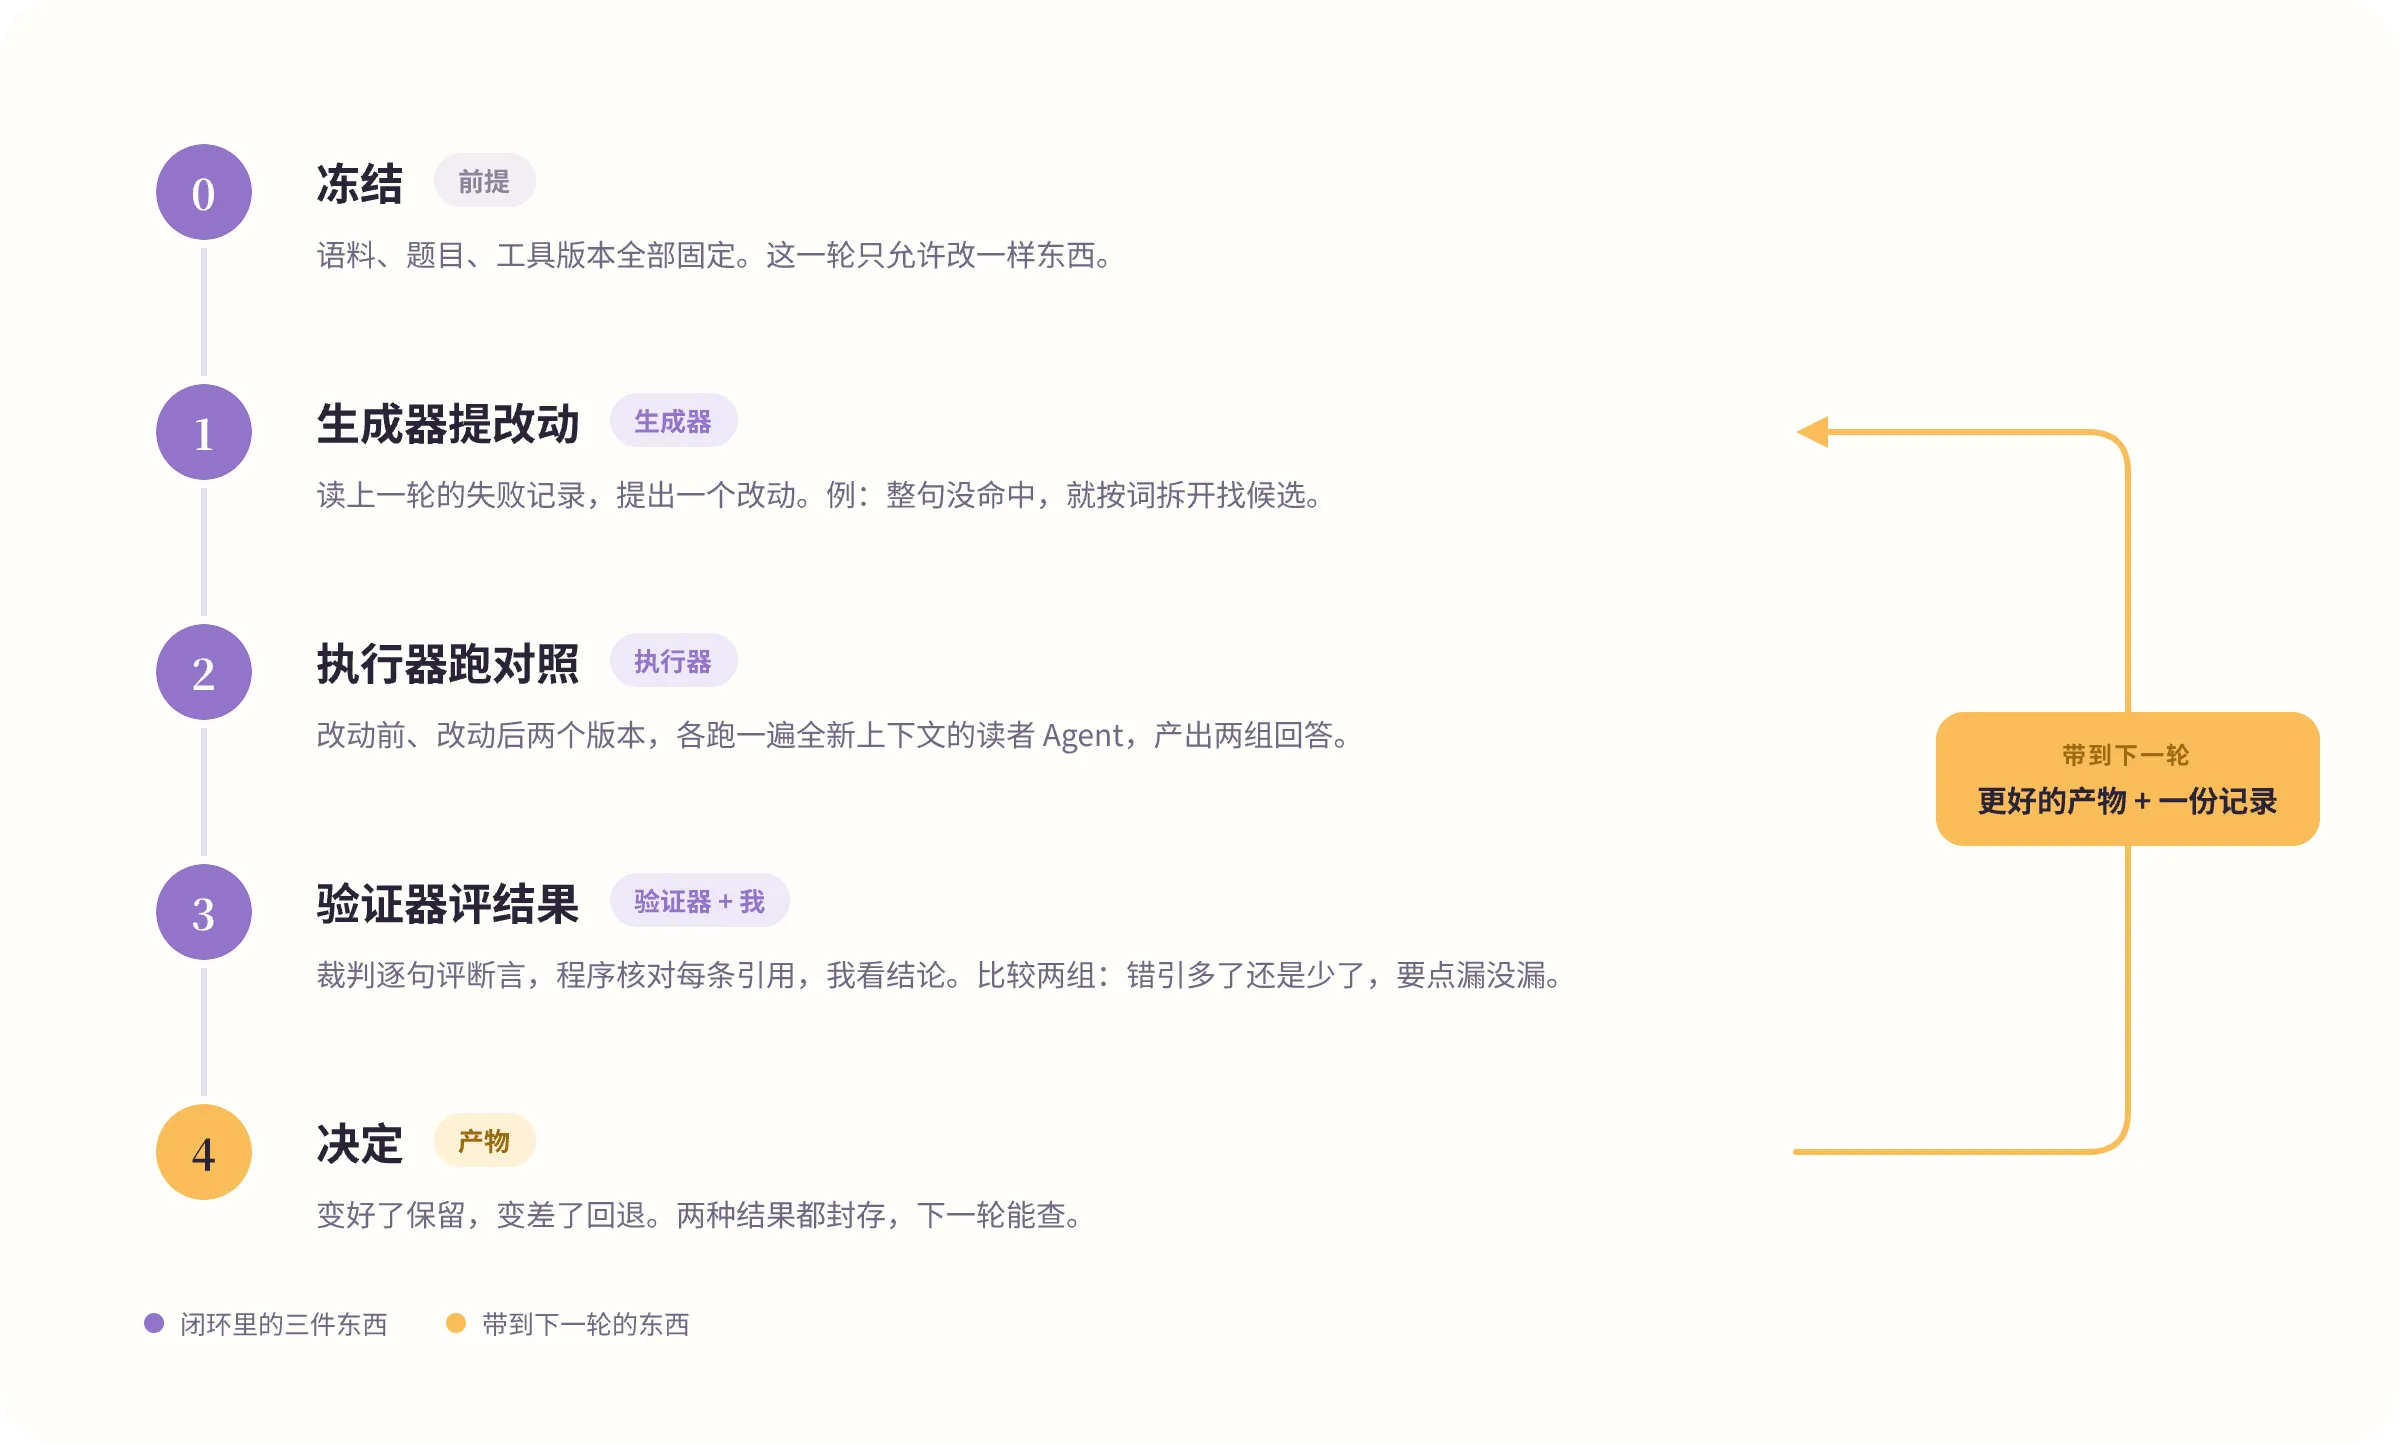
一轮是这样跑的:
把三件东西对上:
- 生成器:读记录、提改动的那个角色。在我的实验里是一个编码 Agent,我只做取舍
- 执行器:冻结语料上批量跑读者 Agent 的脚本
- 验证器:模型裁判 + 引用核验程序 + 我
- 产物(被改的那样东西):检索规则、回答提示、或工具的返回格式
注意第 4 步带到下一轮的是什么:一个更好的产物,加一份记录。生成器下一轮会读这份记录,但它读记录的方式、猜错误的方式、挑改动的方式,和上一轮一模一样。
这就是 SI。产物在变好,生成器在工作,但生成器没有变。
RSI 的一轮多了哪一步
把上面那个流程原样搬过来,RSI 只多一步,但多在关键的地方。
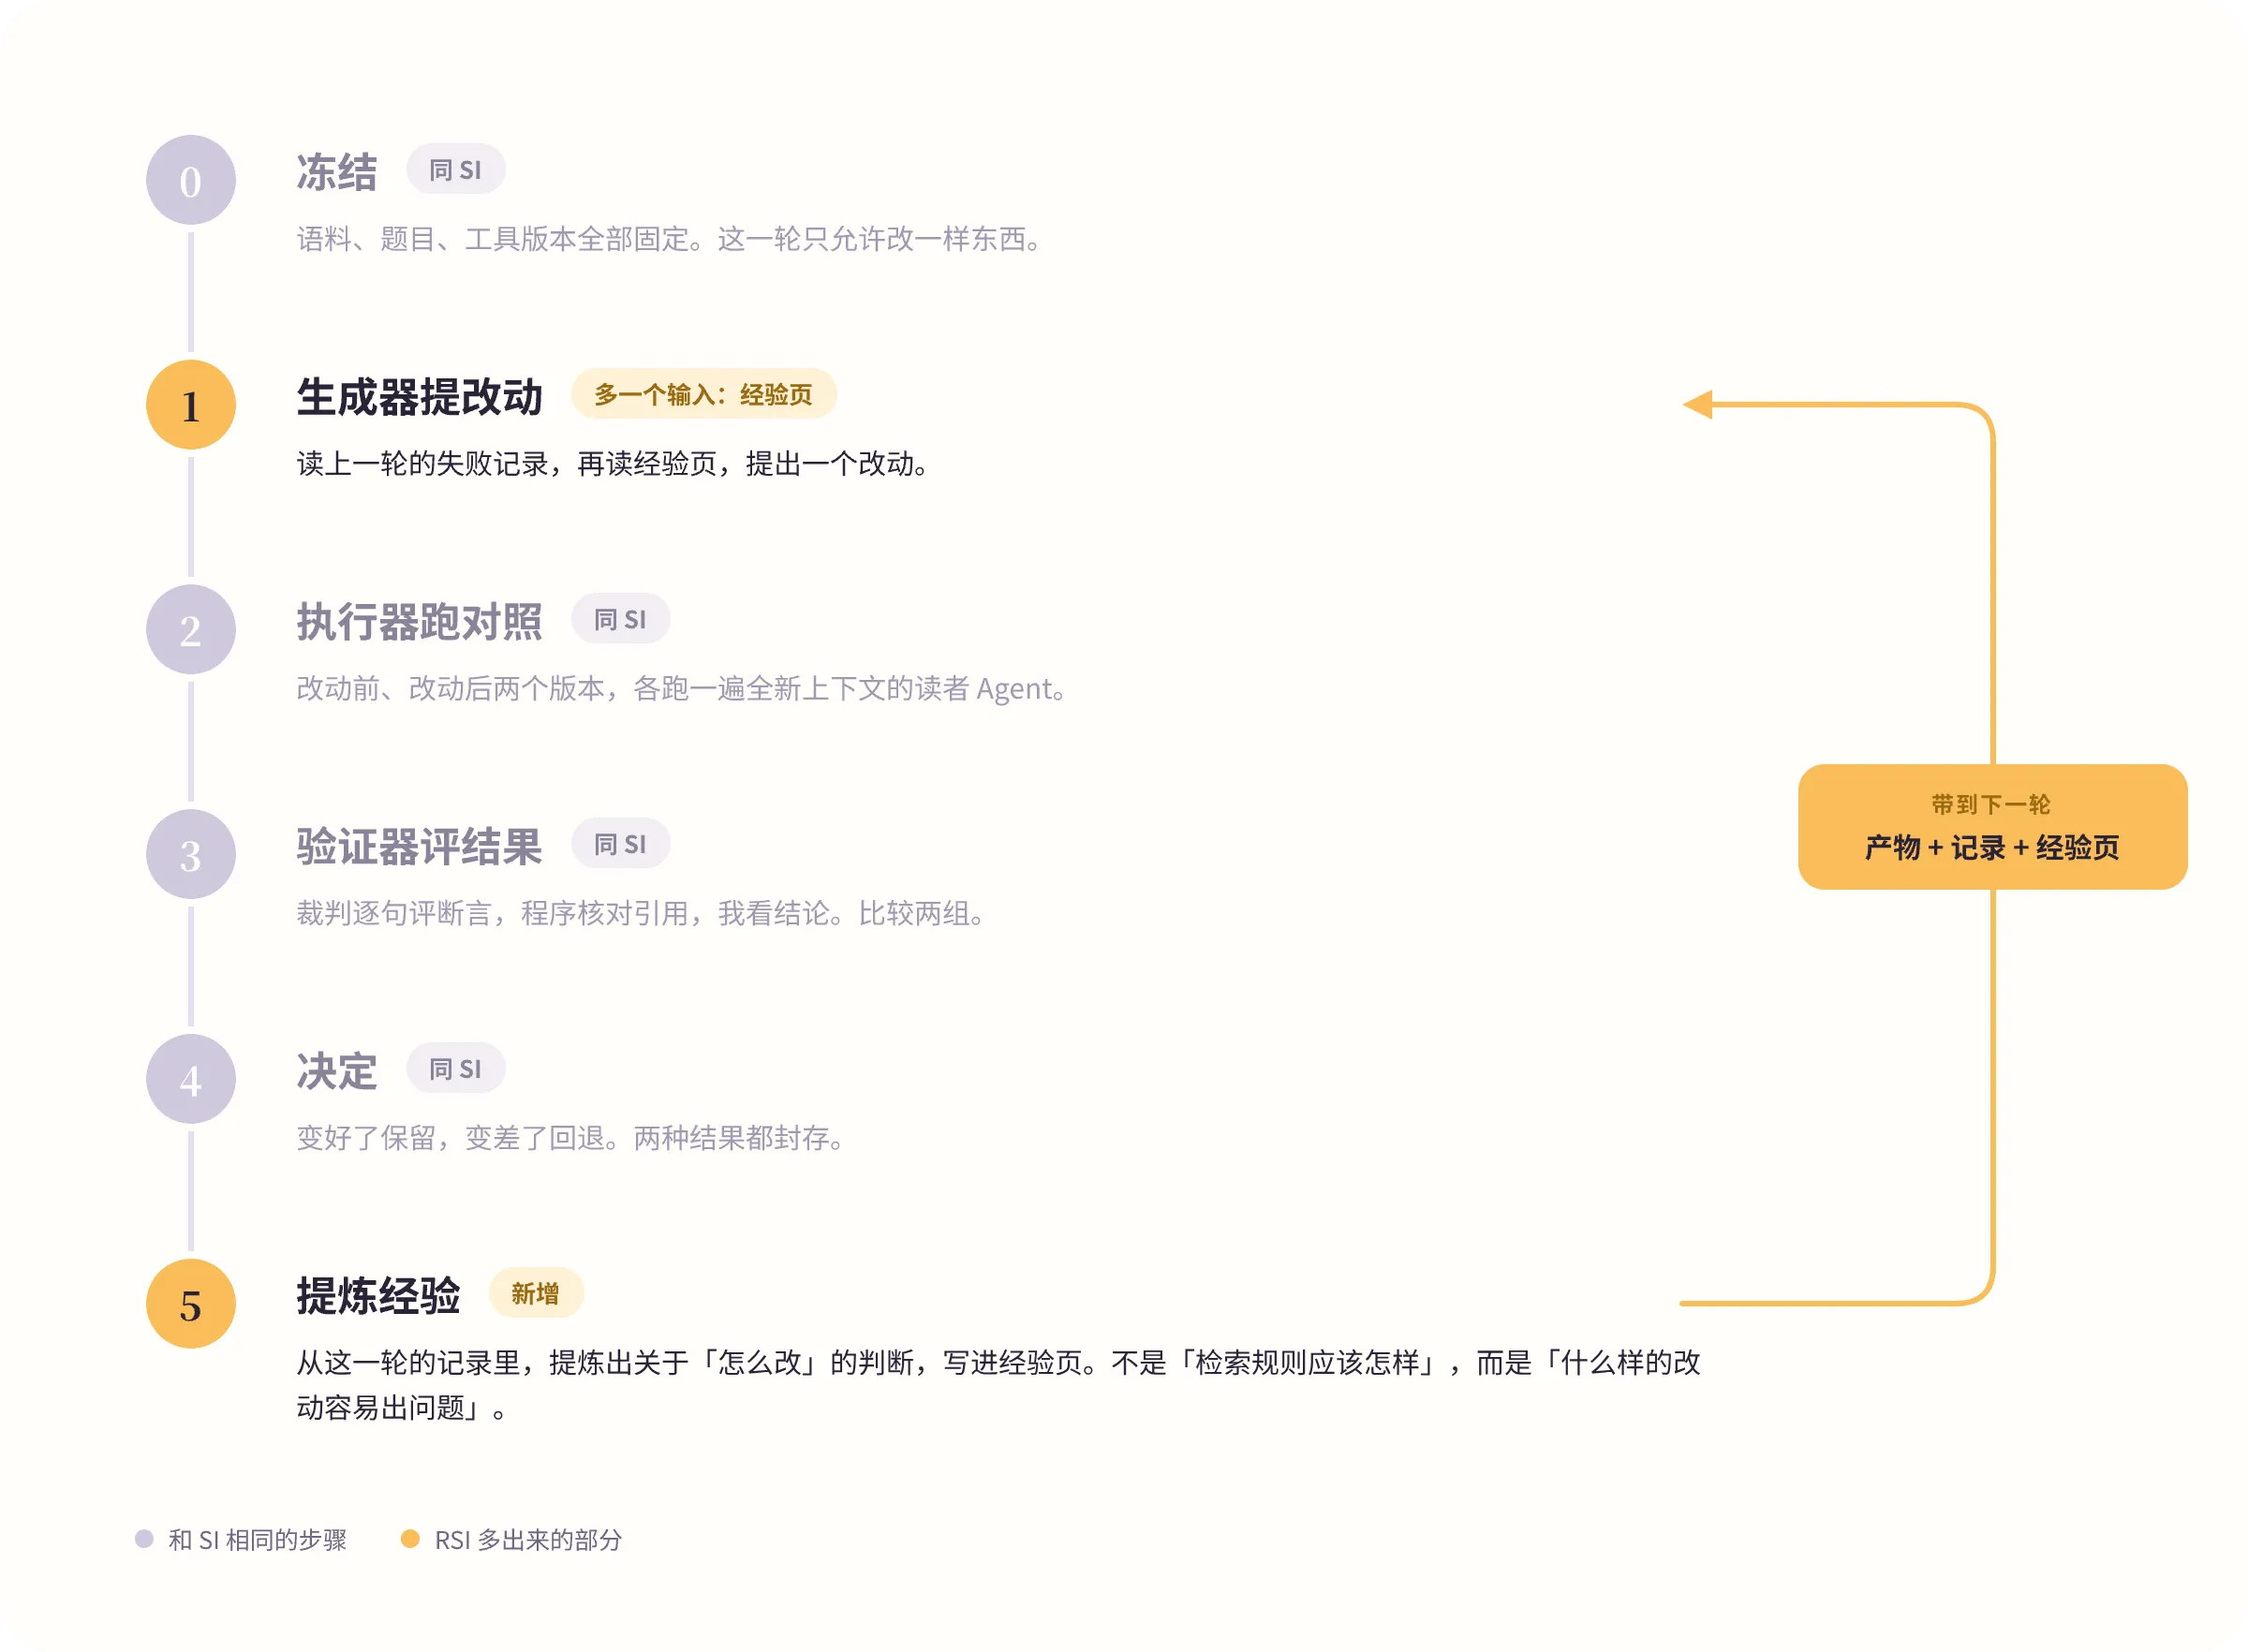
差别只有一条箭头:记录 → 经验 → 生成器。
SI 里,记录只是给生成器看的材料,生成器看完还是原来的生成器。RSI 里,记录被提炼成了关于方法的判断,生成器下一轮带着这些判断工作。改的是它提改动的方式。
两个流程并排放,回答最初提出的那三个问题:
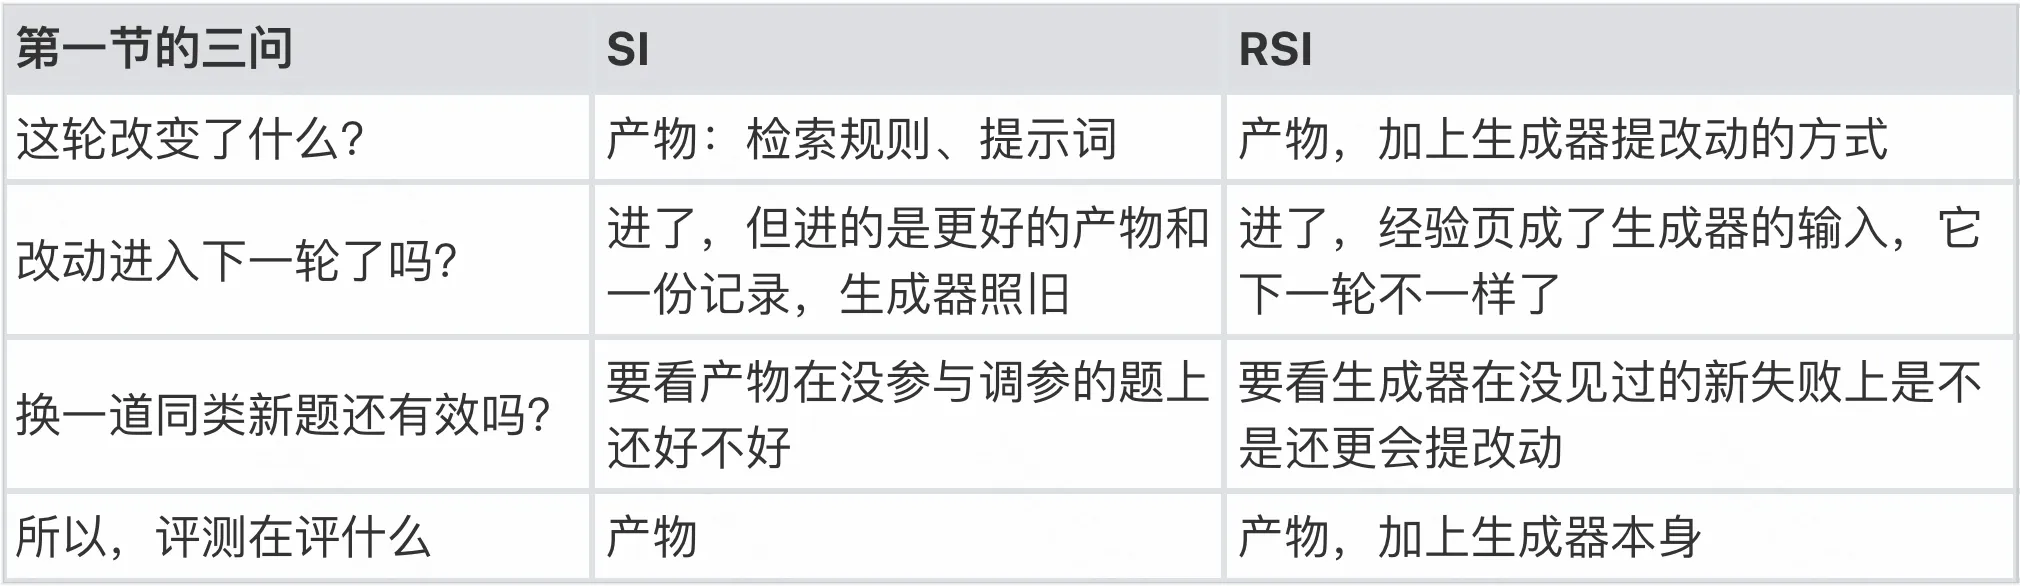
最后一行是 RSI 比 SI 多出来的那一层验证器:不只评产物,还要评提方案的东西。第三问也说明了该怎么评:拿一批生成器没见过的失败,看它是不是真的更会提改动了,而不是碰巧提了个好改动。对生成器本身做一个对照:
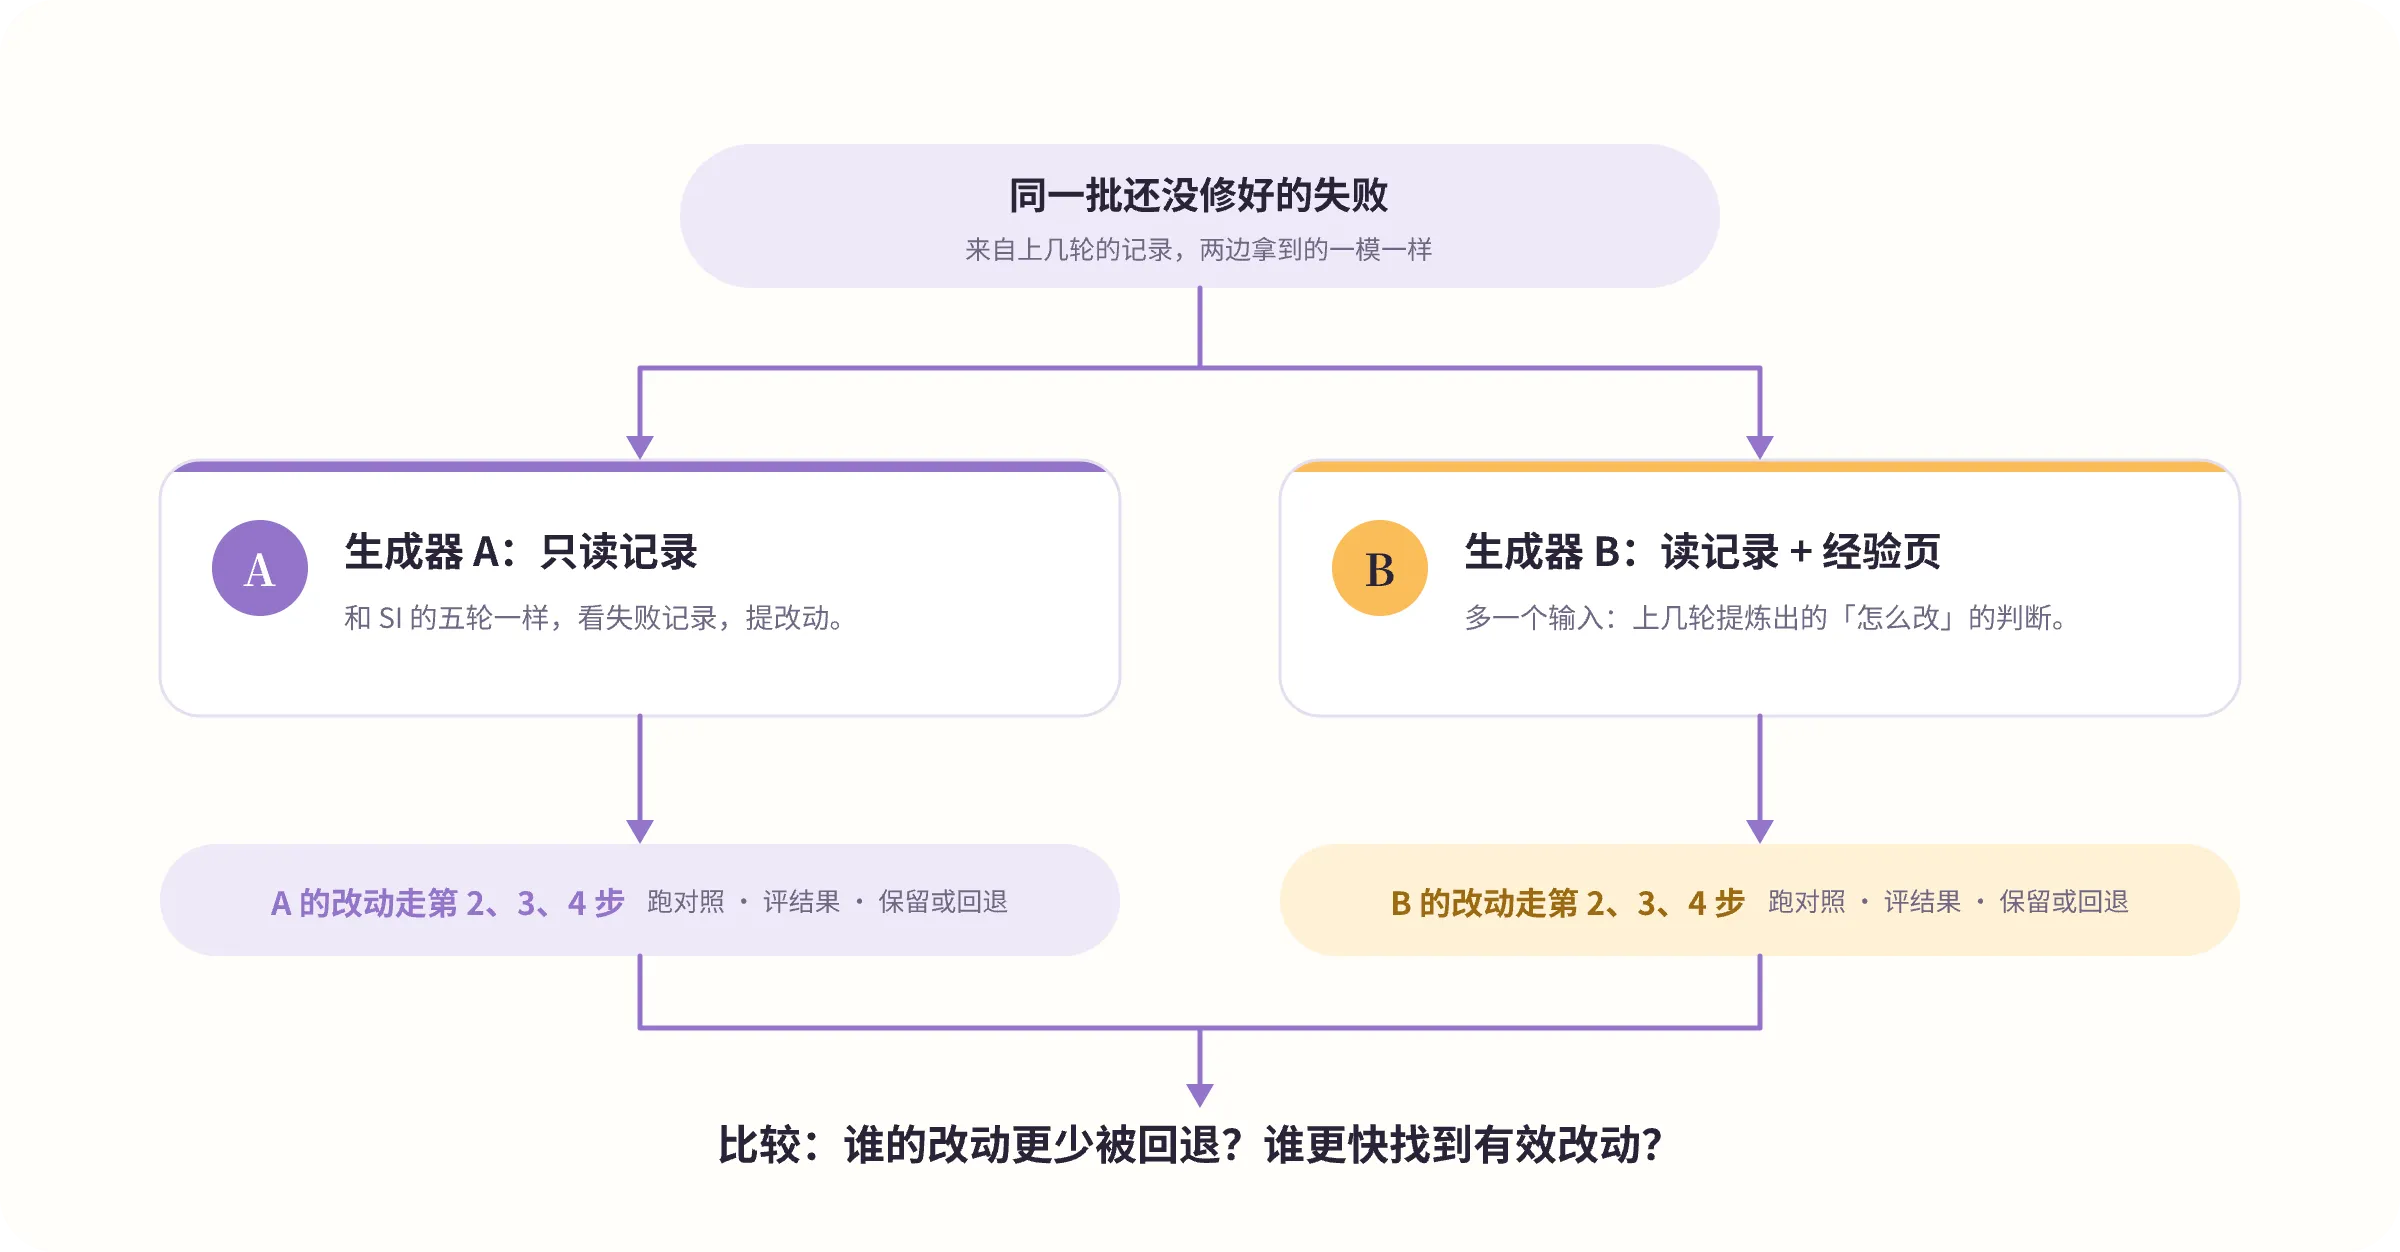
如果 B 明显更好,那就是生成器变了。而且只是外围层的变化,模型权重没动,这才够得上「递归」的边。
实验之后
我这几轮改动全是 SI,产物确实在变好。但第二节说验证器决定循环往哪跑,五轮下来它还决定了另一件事:跑多快。没有一轮是卡在「跑不动」,每一轮卡住的地方都在第 3 步:验证器评结果。
因为这里有一个事实:这个系统问的是「陌生 Agent 有没有准确理解我」,这个问题的最终判决只能是我本人。裁判可以替我初筛,但它准不准要我校准;题目从我的观点推出来,观点准不准也要我确认。
我看审核结果的速度,就是这个闭环的速度上限。自动化缩短的是我之外的部分。
对谈里也提到了同一个现象:长任务里一半以上需要人中途介入,选题和是否扩大规模由人决定。他们的验证器也是人,只是人在很多层里。我的系统只有一层,所以看得特别清楚。
最后
要看清 SI 和 RSI,问两个问题就够:
- 被改的是什么?是产物,还是提方案的系统?
- 谁在验证?验证器有多快、有多准、是不是人?
「Agent 帮我把 X 改得越来越好」不是 RSI,不管 X 多复杂、Agent 多少个。一万个 Agent 并发去找一个证明,改的是证明。研究员的产出被放大几倍,改的是研究员的产出。这些严格意义上都是 SI,只是规模大而已。
所以想让闭环离开人一直跑,难的不是让 Agent 多干活,而是让验证器不再是我。这一步做成了,才轮得到 RSI。
那我先去试试。🤔
参考链接
- 斯坦福 HAI:Jeff Dean 与李飞飞的主题演讲和对谈
- 斯坦福 HAI:RSI 术语说明
- Discovery Loop:创办说明
- I. J. Good, “Speculations Concerning the First Ultraintelligent Machine”, 1965(RSI 概念的理论源头)
核心结论
标注「判断」「假设」的是我的看法而非事实;标注「已推翻」的保留在这里,不删除。
区分自我改进(SI)和递归自我改进(RSI)只看一点:被改进的是产物,还是提出改进的那个系统。规模、并发数和算力都不是判据。#
判断 · 把握较大 — 在 autoresearch-evolves-the-system-not-the-brain 之上加了一层:那条说的是进化发生在哪,这条说的是用它区分 SI 和 RSI。
查看出处与限定
归属待补
论述上下文 · p9 · 关系待复核
所以判据只有一条:被改的是产物,还是提出改进的那个系统。
论述上下文 · p12 · 关系待复核
判据只有一条,但要用它,还要能指出「提出改进的那个系统」是这个循环里的哪一部分。所以要先把循环拆开。👇
论述上下文 · p20 · 关系待复核
上面判据里说的「提出改进的那个系统」,就是生成器。SI 用生成器,RSI 改生成器。 带着这句话看下面的实验。👇
已定位既有公开原句;本人表达、来源摘录或系统推断的归属仍待逐条复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@2),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
任何自我改进闭环都由生成器、执行器、验证器三部分构成;生成器和执行器决定循环跑不跑得动,验证器决定它往哪跑。#
判断 · 把握较大
查看出处与限定
归属待补
论述上下文 · p14 · 关系待复核
任何一个自我改进闭环,拆开都是三件东西:
论述上下文 · p16 · 关系待复核
三件里面,生成器和执行器决定循环跑不跑得动,验证器决定它往哪跑:
论述上下文 · p39 · 关系待复核
我这几轮改动全是 SI,产物确实在变好。但第二节说验证器决定循环往哪跑,五轮下来它还决定了另一件事:跑多快。没有一轮是卡在「跑不动」,每一轮卡住的地方都在第 3 步:验证器评结果。
已定位既有公开原句;本人表达、来源摘录或系统推断的归属仍待逐条复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@2),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
「Agent 帮我把 X 改得越来越好」不是 RSI,不管 X 多复杂、Agent 多少个;一万个 Agent 并发找证明改的仍是证明,研究员被放大几倍改的仍是研究员的产出,这些严格意义上都是 SI。#
判断 · 把握较大
查看出处与限定
归属待补
论述上下文 · p46 · 关系待复核
「Agent 帮我把 X 改得越来越好」不是 RSI,不管 X 多复杂、Agent 多少个。一万个 Agent 并发去找一个证明,改的是证明。研究员的产出被放大几倍,改的是研究员的产出。这些严格意义上都是 SI,只是规模大而已。
已定位既有公开原句;本人表达、来源摘录或系统推断的归属仍待逐条复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@2),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
在只有人能做最终判决的系统里,闭环的速度上限就是人看结果的速度;自动化只能缩短人之外的部分。#
判断 · 把握中等
查看出处与限定
归属待补
论述上下文 · p40 · 关系待复核
因为这里有一个事实:这个系统问的是「陌生 Agent 有没有准确理解我」,这个问题的最终判决只能是我本人。裁判可以替我初筛,但它准不准要我校准;题目从我的观点推出来,观点准不准也要我确认。
论述上下文 · p41 · 关系待复核
我看审核结果的速度,就是这个闭环的速度上限。自动化缩短的是我之外的部分。
论述上下文 · p42 · 关系待复核
对谈里也提到了同一个现象:长任务里一半以上需要人中途介入,选题和是否扩大规模由人决定。他们的验证器也是人,只是人在很多层里。我的系统只有一层,所以看得特别清楚。
已定位既有公开原句;本人表达、来源摘录或系统推断的归属仍待逐条复核。
论证依据及其支持、反驳关系待补;本条原句不作为自身事实证明,也不表示近期重新确认。
依据段落由字面重叠机械定位(bigram-overlap-context@2),只标记论述上下文,未经语义复核;不证明支持关系或事实正确。
引用本文
晨旭,《关于 SI 和 RSI:AI 跑了一万次实验,谁变聪明了?》,晨光里的AI,2026-11-12
[晨旭:《关于 SI 和 RSI:AI 跑了一万次实验,谁变聪明了?》](https://chenxu.xin/writing/ai-rsi-who-gets-better)带进你的 AI 继续追问
这篇文章有一份干净的 Markdown 原文,可以直接交给任何模型读,不用复制粘贴。